Um analista de dados que escreve Python raramente escreveu um sistema. Escreveu um script, depois outro, e depois um terceiro que lê o resultado dos dois primeiros.
Nenhum deles foi planejado como infraestrutura, e todos viraram infraestrutura. O agendador que dispara os três está na máquina de alguém, e o único aviso de falha é o relatório que não chegou na segunda-feira.
O problema é que "usar Python para dados" descreve três atividades muito diferentes, com valores muito diferentes. Uma delas justifica a linguagem sozinha. Outra é hábito, e existe alternativa mais simples. A terceira é manutenção que ninguém pediu e ninguém orçou.
Neste artigo, separamos as três camadas — trazer, transformar e analisar — e mostramos qual delas vale a pena continuar escrevendo em Python.
Camada 1 — trazer o dado
É o script que chama a API, trata o retorno e grava em algum lugar. Escrever a primeira versão é rápido: uma tarde resolve. O que ninguém orça é o que vem depois.
- Autenticação que expira e precisa ser renovada no meio da execução.
- Resultado partido em páginas, cada API com a sua regra de paginação.
- Limite de chamadas, que obriga a esperar e a tentar de novo.
- A API que muda de formato sem avisar ninguém.
- Controle do que já foi lido, para não puxar a base inteira toda vez.
- Registro do que aconteceu, para alguém entender a falha de terça-feira.
- Agendamento, e um jeito de saber que ele não rodou.
Nada disso é análise de dados: é engenharia de sistemas, escrita por quem foi contratado para outra coisa.
E o custo real não está na escrita, está na propriedade. Um script é gerenciável, mas quinze são um sistema sem dono, sem aviso de falha e sem ninguém que saiba explicar por que aquele campo está diferente.
Exemplo prático
Uma equipe de marketing acompanha o custo por lead num painel alimentado por um script que lê a API de anúncios toda madrugada. Em março, a API passa a exigir um parâmetro novo e devolve só a primeira página do resultado. O script não quebra: grava o que veio e termina com sucesso. O painel segue atualizando com um terço dos dados, e ninguém percebe até o fechamento do mês.
A pergunta que expõe o risco é outra: se a pessoa que escreveu sair da empresa, alguém dá manutenção? Script que falha em silêncio é pior que script quebrado.
Camada 2 — transformar o dado
Aqui o Python aparece por hábito mais do que por necessidade.
Ler três tabelas com pandas, juntar, agrupar, calcular e gravar o resultado é uma operação que o banco de dados faz melhor. Não por elegância — por três motivos concretos.
Memória. O pandas carrega tudo antes de processar, e o banco não precisa. A partir de certo volume, o script morre por falta de memória num lugar onde uma consulta rodaria sem esforço. O sintoma clássico é o código que roda na sua máquina e morre no servidor.
Reprodutibilidade. A ordem das operações num script longo importa, e nem sempre está explícita. Em SQL, a declaração é o resultado.
Quem consegue ler. Uma transformação em SQL pode ser lida, revisada e corrigida por qualquer pessoa do time de dados. O mesmo cálculo em pandas costuma ter um único leitor: quem escreveu.
Há exceções legítimas. Manipulação de texto complexa, chamada a um serviço externo no meio da transformação, lógica que o SQL expressa mal. Nesses casos, Python é a resposta certa, e não há motivo para forçar a barra.
Fora dessas exceções, o banco transforma melhor e mais barato.
Camada 3 — analisar o dado
Esta camada não sai do Python, e não deveria sair. É aqui que a linguagem faz o que nenhuma outra ferramenta do fluxo faz.
Regressão, série temporal, agrupamento estatístico, teste de hipótese, modelo de previsão, simulação. Gráfico que exige controle fino sobre cada eixo. Análise exploratória em que a pergunta muda a cada célula executada.
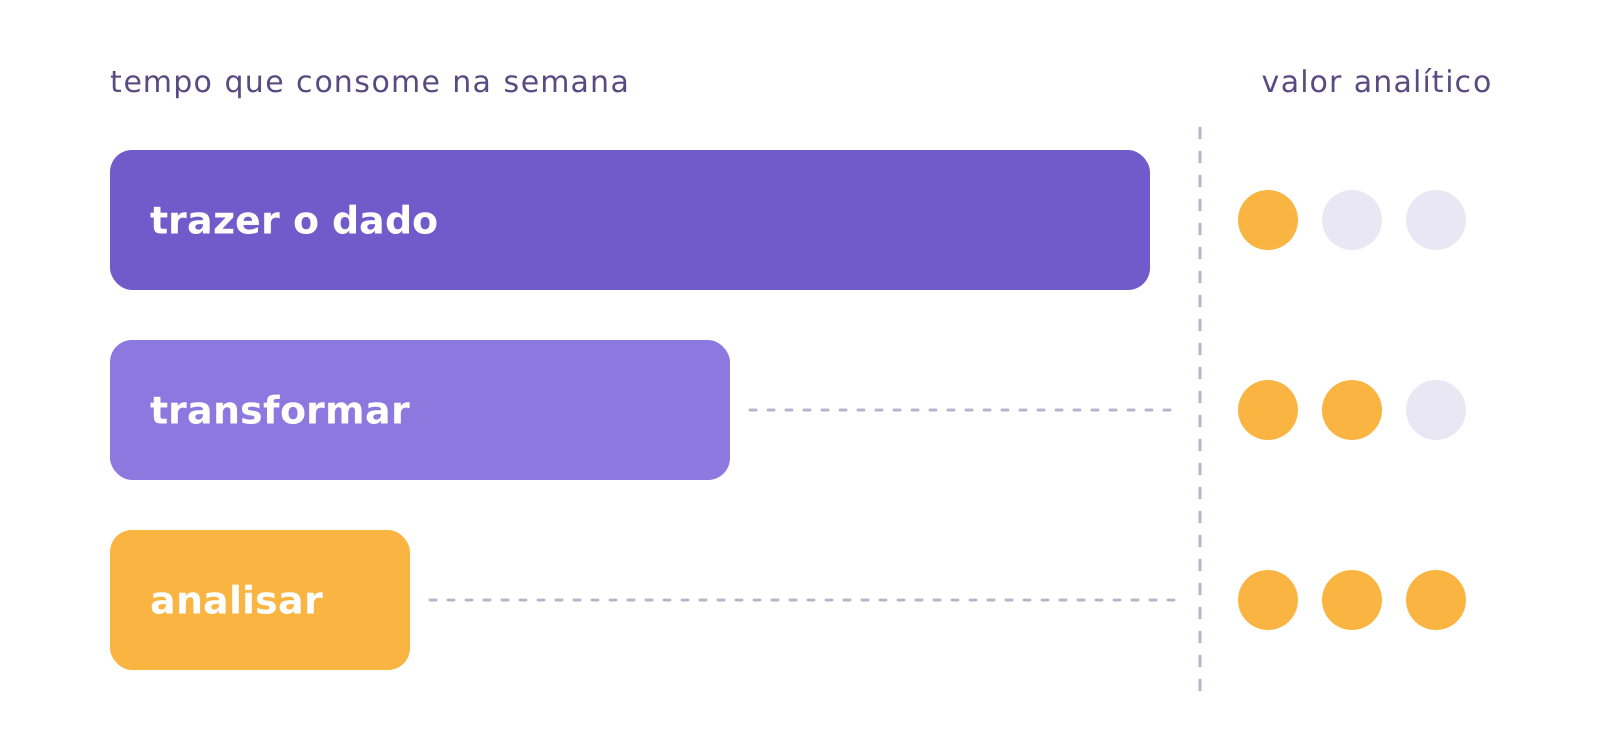
SQL não faz isso, e ferramenta de painel também não. É o trabalho de maior valor no fluxo inteiro, e é justamente o que mais sofre quando as camadas 1 e 2 consomem a semana.
Repare no que separa as três. A primeira e a segunda são meio: ninguém contrata um time de dados para autenticar em API nem para juntar tabela. A terceira é fim — a resposta que alguém pediu, e a única que aparece na reunião de segunda.
Quem promete substituir esta camada por uma interface está vendendo algo que não existe. Nenhuma interface faz a pergunta por você.
Como saber qual camada está custando caro
Três perguntas, e a resposta honesta costuma incomodar:
Quanto da sua semana é camada 1? Se mais de um terço do tempo vai para trazer o dado e consertar o que quebrou trazendo, o gargalo não é analítico.
Quantos dos seus scripts alguém além de você consegue manter? Se a resposta é nenhum, isso não é patrimônio técnico, e sim risco concentrado numa pessoa só.
Quando foi a última análise de verdade que você fez? Modelo, teste, investigação. Se a resposta é "faz tempo", a camada 3 está sendo esmagada pelas outras duas.
Se as três respostas apontarem para o mesmo lado, o problema não é de linguagem. É de divisão de trabalho.
Onde o Januss entra
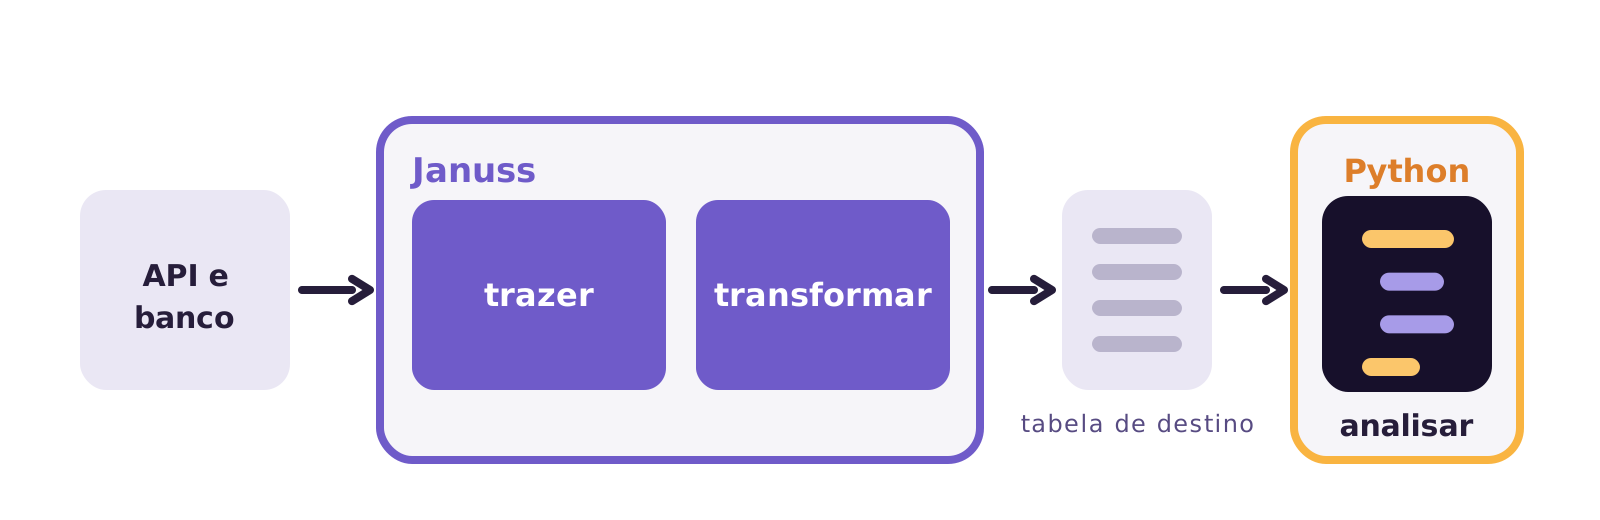
O Januss cobre as camadas 1 e 2, e não toca na camada 3.
Na camada 1, a IA escreve o conector a partir da especificação OpenAPI da API ou da documentação que você colar. Ela resolve autenticação e paginação, e o conector só é salvo depois de uma chamada real que conseguiu ler o dado. Depois disso ele é determinístico: a extração roda sempre igual, sem IA no caminho do dado.
Agendamento, repetição em caso de falha, aviso por e-mail e controle do que já foi lido vêm junto. Para bancos de dados, a leitura é do log de transações, o que resolve carga incremental e exclusão sem código nenhum.
Na camada 2, a transformação é escrita em SQL e executada dentro do banco de destino, com dependência entre etapas e reprocessamento só do escopo que mudou. Antes disso, treze regras de conversão por coluna — moeda, data, número, texto — com oito formatos regionais, e a decisão, coluna a coluna, entre parar a execução e gravar nulo. Os testes declarados podem interromper a carga quando o dado chega errado.
Na camada 3, nada muda. O banco alimentado continua sendo a origem do seu ambiente de análise. O pandas.read_sql continua ali. A diferença é que ele lê de uma tabela confiável, atualizada sozinha, em vez de ler do resultado de um script que talvez tenha rodado.
Vale dizer o que isso não é: não é "análise de dados sem programar". Quem faz modelo estatístico em Python vai continuar fazendo, e deve. O que sai da conta é a parte que nunca foi análise — a que consome a semana e não aparece em relatório nenhum.
Quer ver com uma origem sua? São 14 dias de teste, sem cartão de crédito: criar seu ambiente.
Crie seu workspace em minutos.
Aponte para a sua origem e veja o dado chegando ao banco no mesmo dia.