Os três aparecem na mesma conversa e são tratados como alternativas. Não são.
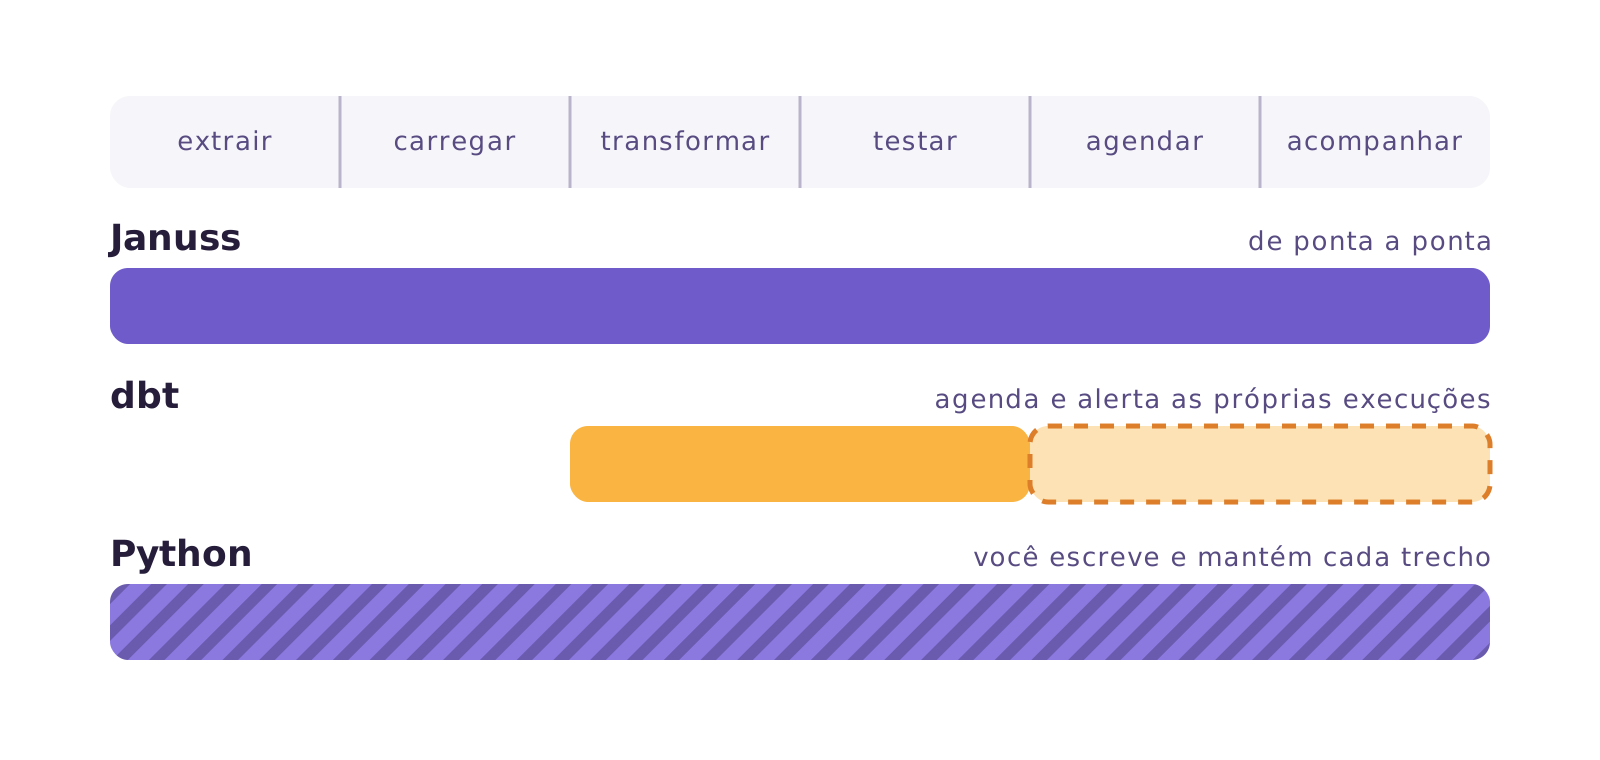
O caminho do dado tem seis trechos: extrair da origem, carregar no destino, transformar, testar, agendar e acompanhar. Cada uma das três opções cobre uma extensão diferente desse caminho, e a diferença não aparece numa lista de recursos.
O problema é que comparar por recurso produz um empate confuso, porque eles ocupam posições diferentes na cadeia. Comparar por trecho coberto leva à pergunta que decide: o que sobra para o seu time construir e manter?
Neste artigo, percorremos os seis trechos com os três — incluindo o que o Januss não faz e o dbt faz bem, e o que mudou desde que dbt Labs e Fivetran viraram a mesma empresa.
O trecho que decide: quem traz o dado
Comece pelo começo do caminho, porque é ele que define o tamanho do resto.
No Januss, trazer o dado é uma tela. Para uma API, a IA escreve o conector a partir da especificação OpenAPI ou da documentação que você colar. Ela resolve autenticação e paginação, e o conector só é salvo depois de uma chamada real que conseguiu ler o dado.
Para banco, a leitura é do log de transações em PostgreSQL, MySQL, SQL Server, Oracle e MongoDB. É o que traz a carga incremental junto, e é também o que faz a exclusão aparecer. Quem lê o log vê a linha ser apagada; quem consulta a tabela por agendamento só vê que ela sumiu.
Em Python, cada um desses itens é uma decisão sua. Renovar o token que expirou no meio da execução, seguir a regra de paginação daquela API, respeitar o limite de chamadas, guardar até onde você leu, repetir quando falhar.
E o dbt não extrai nada. Ele trabalha sobre dado que já está no destino. Não é crítica: é o desenho da ferramenta, declarado por quem a construiu. Mas tem uma consequência prática que se perde na hora de comparar — a resposta do dbt nunca é a cadeia inteira, e quem coloca o dado lá é outra peça.
É por isso que este é o trecho que decide o resto.
Os seis trechos, lado a lado
A tabela compara o desenho de cada um, trecho a trecho. Ela não dá nota a ninguém: descreve como cada ferramenta foi construída, e é a partir daí que a escolha fica possível.
Três linhas concentram a decisão. A primeira e a segunda, porque separam quem move o dado de quem só trabalha com ele depois de movido. A quarta, porque define se o dado reprovado chega ou não ao destino.
As duas últimas linhas vão na direção contrária, e é bom que fiquem visíveis: o dbt versiona e documenta a transformação, e o Januss não faz nem uma coisa nem outra. Quem trabalha com repositório vai pesar isso, e deve.
| Januss | dbt | Python | |
|---|---|---|---|
| Extrair da origem | Conector de API escrito pela IA e validado com chamada real; leitura de log em cinco bancos | Fora do desenho: trabalha sobre dado que já chegou | Você escreve, da autenticação à paginação |
| Carregar no destino | Onze destinos, com o modo de sincronização escolhido por tabela | Fora do desenho | Você escreve, e mantém |
| Transformar | SQL executado dentro do banco de destino, com dependência entre etapas | Modelos em SQL versionados, com macros e pacotes prontos | SQL ou pandas, com o limite da memória do processo |
| Quando o teste reprova | Pode parar a execução antes de gravar e bloquear o que vem depois | Acusa na tabela já construída, com severidade de aviso ou erro | O que você tiver escrito |
| Agendar | Vem junto: onze frequências de 5 min a 24 h, mais cron | A plataforma dbt agenda; o dbt Core pede um orquestrador | Você configura fora do script |
| Acompanhar e alertar | E-mail de falha e de recuperação, e desligamento depois de três falhas seguidas | E-mail, Slack e Microsoft Teams por resultado de execução | Você escreve |
| Versionar a transformação | Não versiona: o SQL é editado e executado na plataforma | Repositório, revisão e integração contínua são o desenho | Repositório, se o time já trabalhar assim |
| Documentar o modelo | Não gera documentação a partir do código | Gera do próprio código | Você escreve |
| Exige do time | SQL | SQL e prática de engenharia de software | Python, infraestrutura e alguém de plantão |
As linhas descrevem o desenho de cada ferramenta, não uma nota de qualidade. O material público do dbt foi consultado em 26 de agosto de 2026.
O que o dbt faz com a transformação
O dbt trouxe para a transformação de dados a disciplina que o desenvolvimento de software já tinha. Cada modelo é um arquivo em SQL, versionado em repositório, revisado antes de entrar, testado a cada alteração e documentado a partir do próprio código.
Para um time com essa prática, é difícil de superar. Modelos incrementais, macros que evitam repetição, um ecossistema grande de pacotes, e um agendador próprio na plataforma com job de implantação, de integração contínua e de merge.
O Januss não é um ambiente de desenvolvimento de transformações. O SQL é escrito e executado na plataforma: não há repositório, não há revisão de alteração antes de entrar e não há documentação gerada do código. Um time que já trabalha assim vai sentir falta das três coisas.
A parte aberta continua aberta, e isso importa para quem teme depender de um fornecedor: o motor Fusion foi publicado sob licença Apache 2.0, como dbt Core v2.0. Quem roda o dbt Core mantém o que já tinha, e paga a plataforma só se quiser o agendador e o resto.
O que o dbt pressupõe também é um custo. Repositório, revisão e automação de teste são prática, não instalação. Um time de duas pessoas que nunca trabalhou assim adota a ferramenta sem adotar a prática, e fica com a complexidade sem o benefício.
Ferramenta se instala numa tarde. Prática, não.
Python cobre tudo, e você mantém tudo
Com Python você faz os seis trechos. Extrai, carrega, transforma, testa, agenda e monitora, sem conector faltando e sem mensalidade.
O que você faz é também tudo o que precisa manter.
Autenticação que expira, resultado partido em páginas, limite de chamadas, controle do que já foi lido, repetição em caso de falha, aviso quando não rodou. Cada item desses é código que alguém escreveu uma vez e alguém vai depurar às sete da manhã.
E o custo maior não é o tempo, é a concentração. Quando o conhecimento de como o dado chega está na cabeça de uma pessoa, a empresa tem um risco que não aparece em planilha nenhuma.
Há uma exceção que vale dizer, porque ela é real. Às vezes a lógica de extração é genuinamente incomum: um protocolo antigo, um arquivo com formato próprio, uma regra de negócio no meio da leitura. Nesses casos o script é a resposta certa, e nenhuma plataforma vai cobrir aquilo melhor.
Para uma integração estável, com quem domina a linguagem, o script é decisão legítima. Para quinze, é um sistema que ninguém decidiu construir.
dbt e Fivetran na mesma empresa
Em 1º de junho de 2026, a fusão entre dbt Labs e Fivetran foi concluída. É a mesma empresa desde então, com os dois produtos ainda vendidos e operados separadamente, e com lançamentos conjuntos anunciados.
Para quem compara ferramentas, isso muda menos do que parece — e confirma o argumento do começo deste artigo. Transformar e movimentar continuam sendo duas peças, com duas configurações e dois lugares para investigar quando o número aparece errado na segunda-feira. O que mudou é que as duas peças agora podem vir da mesma casa.
Há um efeito prático que vale acompanhar. Quando duas peças passam a ser vendidas pela mesma empresa, a integração entre elas tende a melhorar e o contrato tende a virar um só. Nada disso muda o número de configurações que alguém precisa manter em pé.
Para o time pequeno, a pergunta não é de quem são as peças. É quantas ele vai sustentar.
O que acontece quando o dado vem errado
Este é o eixo em que os três se separam mais, e o que menos aparece numa comparação de recursos.
No Januss, o teste roda na carga. Campo obrigatório vazio, chave duplicada, relacionamento quebrado, valor fora de uma lista: cada teste pode só registrar um aviso ou parar a execução e bloquear as etapas seguintes. O dado reprovado não chega ao destino.
No dbt, o teste é uma consulta sobre o modelo já construído, com severidade de aviso ou de erro. Ele acusa depois que a tabela existe — e é excelente nisso, com histórico e documentação do que falhou.
Em Python, acontece o que você escreveu. Se ninguém escreveu, o dado entra.
A diferença não é de rigor, é de momento. Testar depois dá um histórico melhor do que falhou e por quê. Testar antes evita que alguém tome uma decisão com o número errado entre a carga e a correção — e essa janela costuma durar uma manhã inteira.
Exemplo prático
A origem passa a mandar o desconto como texto com vírgula decimal, e a conversão devolve zero em toda linha que tem centavos. Com o teste na carga, a execução para e o painel segue no número da véspera, correto. Com o teste depois, o painel atualiza com o número errado. O alerta chega junto, mas chega com o número já na tela de quem pediu o relatório.
As três respostas são diferentes, e a diferença aparece no painel.
Como decidir
Quem vai manter a extração? É o trecho que o dbt não cobre e o que mais consome tempo em Python. Se a resposta for "eu, nas horas vagas", ela decide sozinha.
Seu time trabalha com repositório e revisão de código? Se sim, o dbt vale o custo de adoção e faz a transformação melhor do que o Januss faz. Se não, adotar dbt traz a complexidade sem o benefício.
Quantas peças você quer manter de pé? Cada uma a mais é mais um lugar para configurar, acompanhar e investigar quando o número aparece errado.
O dado errado pode chegar ao destino? Se a resposta é não, o teste precisa rodar antes da gravação, e não depois dela.
Não existe combinação certa em abstrato. Existe a que corresponde ao time de hoje.
Onde o Januss entra
O Januss foi construído para o time que sabe SQL, responde pelo número e não tem — nem quer ter — uma prática de engenharia de dados para sustentar.
Extração com conector escrito pela IA e leitura de log. Carga em onze destinos, com o modo de sincronização escolhido por tabela. Transformação em SQL dentro do destino, com testes que interrompem a carga antes de o dado errado chegar. Agendamento, alerta por e-mail e desligamento automático depois de três falhas seguidas.
São os seis trechos numa configuração só. O que muda a conta do time pequeno não é o preço de cada peça: é o número de peças que alguém precisa entender para responder por que o número da segunda-feira está diferente.
Se o seu time já versiona modelos em repositório e roda teste automatizado a cada alteração, o dbt continua fazendo a transformação melhor. E se você tem uma integração estável e domina Python, o script continua sendo defensável.
O caro é o do meio: quinze scripts que ninguém decidiu construir, ou uma prática de engenharia adotada pela metade.
Quer ver a cadeia inteira com uma origem sua? São 14 dias de teste, sem cartão de crédito: criar seu ambiente.
Crie seu workspace em minutos.
Aponte para a sua origem e veja o dado chegando ao banco no mesmo dia.