O contrato do sistema novo está assinado e a virada foi marcada para o primeiro dia do trimestre. O fornecedor pede o histórico em CSV, o time de TI exporta as tabelas e o cronograma cabe em três semanas.
Só que a primeira importação para no meio, com a mensagem de que o valor não cabe no tipo da coluna. Depois o financeiro abre o sistema novo e não encontra os pedidos cancelados de 2019. Nenhum dos dois problemas é de volume.
O que atrasa uma migração são os campos que ninguém mapeou, as datas gravadas em três formatos e a tabela que a operação alimentava à mão. Nada disso aparece na estimativa de prazo. Aparece na primeira carga.
Neste artigo, explicamos o que separa migração de integração, os quatro cenários em que ela aparece, as duas formas de executar e como conferir que o dado chegou inteiro.
Migração de dados não é integração
A confusão entre as duas é a causa mais comum de projeto de migração estourado.
Migração tem fim. É uma mudança de endereço: o dado sai de um lugar, chega em outro e o lugar antigo é desligado. O sucesso se mede uma vez — chegou tudo, chegou certo, a operação continuou.
Integração é rotina. Ela não termina: todo dia o dado novo precisa chegar, e o sucesso se mede todo dia.
Quem trata migração como integração monta uma estrutura permanente para um problema temporário. Quem trata integração como migração faz uma carga heroica e, na semana seguinte, descobre que ninguém pensou em como manter aquilo atualizado.
A pergunta que separa as duas é uma só: o sistema de origem vai ser desligado? Se vai, é migração, e ela tem data para acabar. Se não vai, os dois sistemas vão conviver, e isso é integração — com rotina, monitoramento e conta que se repete todo mês.
Troca de sistema, nuvem, consolidação e analítica
Troca de sistema de gestão. É o cenário mais comum e o mais difícil, porque sistemas diferentes modelam o mesmo negócio de formas diferentes. Não existe correspondência direta de campo a campo, e alguém precisa decidir o que vira o quê.
Saída do servidor local para a nuvem. Tecnicamente é o mais simples, porque a estrutura costuma ser preservada. O desafio é a janela: quanto tempo a operação pode ficar parada.
Consolidação de vários bancos em um. Aparece depois de fusão ou aquisição, e depois de anos de sistemas que cresceram separados. O trabalho não é mover — é reconciliar chaves e identificar o mesmo cliente cadastrado em três lugares.
Troca de plataforma analítica. Sair de um armazém de dados para outro costuma ser subestimado, porque parece só recarregar. Até alguém lembrar dos relatórios que dependem daquele modelo.
Os quatro exigem o mesmo cuidado por motivos diferentes: nos dois primeiros o risco é a janela de parada, nos dois últimos é o modelo de dados.
Parada programada ou migração contínua
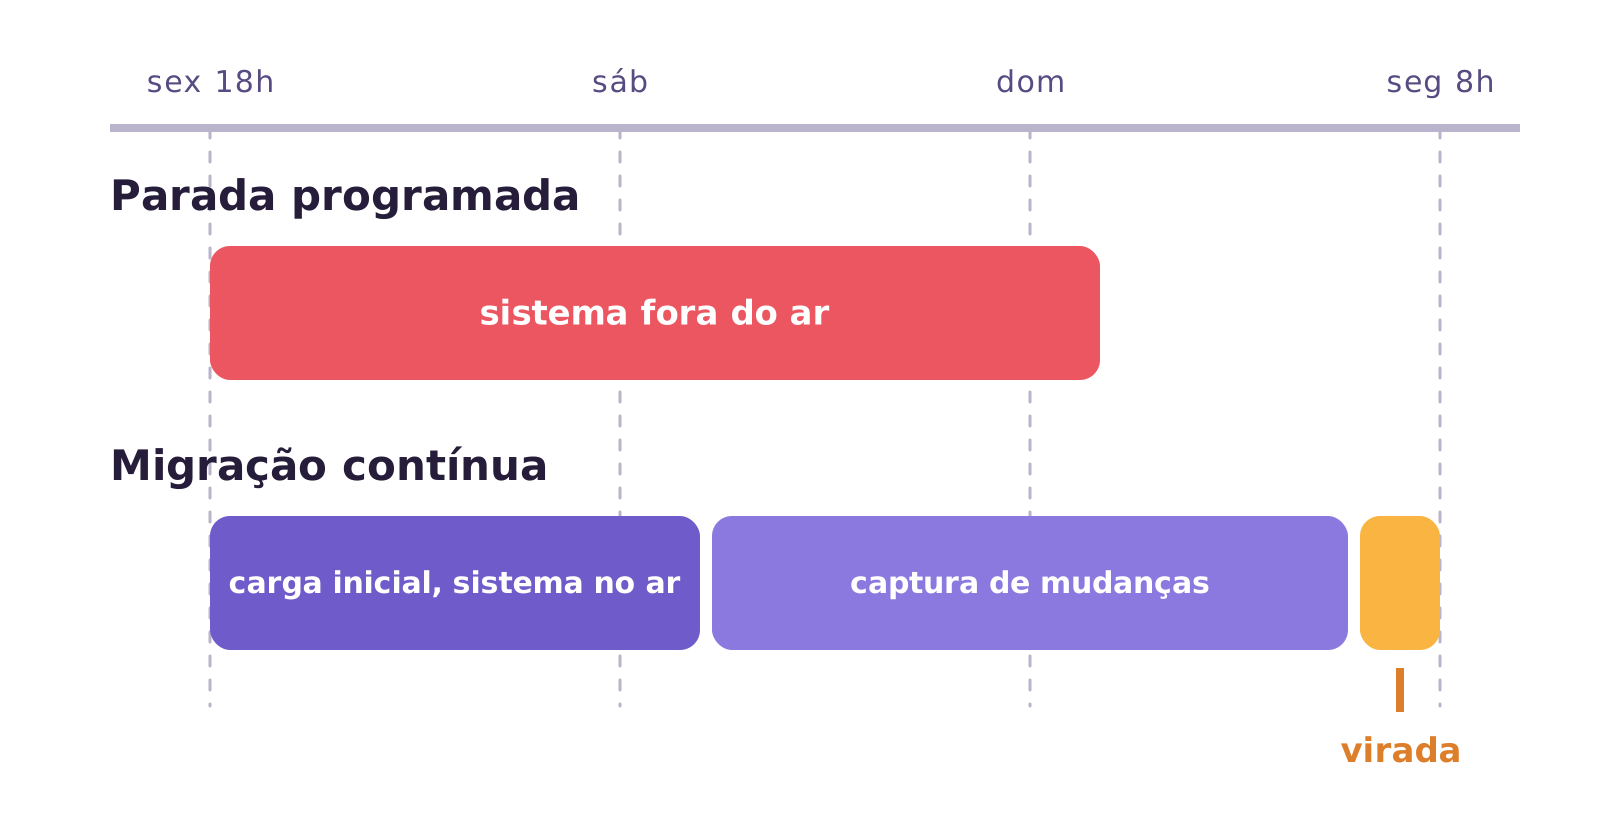
Parada programada. Você desliga o sistema numa sexta à noite, move tudo, valida no sábado e religa no domingo. É simples de entender e de coordenar.
O problema é o tamanho da janela. Se a carga demora mais que o previsto, a decisão de segunda-feira de manhã é entre voltar atrás e operar com dado incompleto. Funciona quando o volume cabe na janela e a operação aceita ficar parada.
Migração contínua. São três etapas: uma carga inicial completa com o sistema de origem rodando normalmente, a captura das mudanças que acontecem durante e depois dessa carga, e a virada.
Com os dois lados idênticos, a operação passa para o sistema novo. A janela de parada deixa de ser o tempo da carga e passa a ser o tempo da virada — de um fim de semana para alguns minutos.
O custo é a complexidade: exige leitura do log de transações no banco de origem e alguém acompanhando a diferença entre os dois lados até a virada. Nenhuma das duas sai de graça, e a escolha é entre parar a operação e sustentar dois sistemas por algumas semanas.
Onde as migrações dão errado
O que estoura o cronograma quase nunca é o volume, e sim o que ninguém mapeou antes de começar.
- Formato e tipo. A data que vem como texto, o valor com separador brasileiro, o campo de sim ou não gravado como S e N em um sistema e 1 e 0 em outro.
- Chave que não existe. Tabela sem chave primária no sistema antigo. Sem ela, não há como identificar a linha que mudou nem como conferir se ela chegou.
- O que a operação mantinha à mão. A planilha de exceções e o campo de observação onde alguém escrevia informação estruturada. Não está no modelo e é indispensável.
- Registro apagado. Se a origem exclui fisicamente e você não captura essa exclusão, o destino acumula dado que já não existe.
- A validação deixada para o fim. Descobrir na véspera da virada que faltam 40 mil linhas é o pior momento possível para descobrir isso.
Exemplo prático
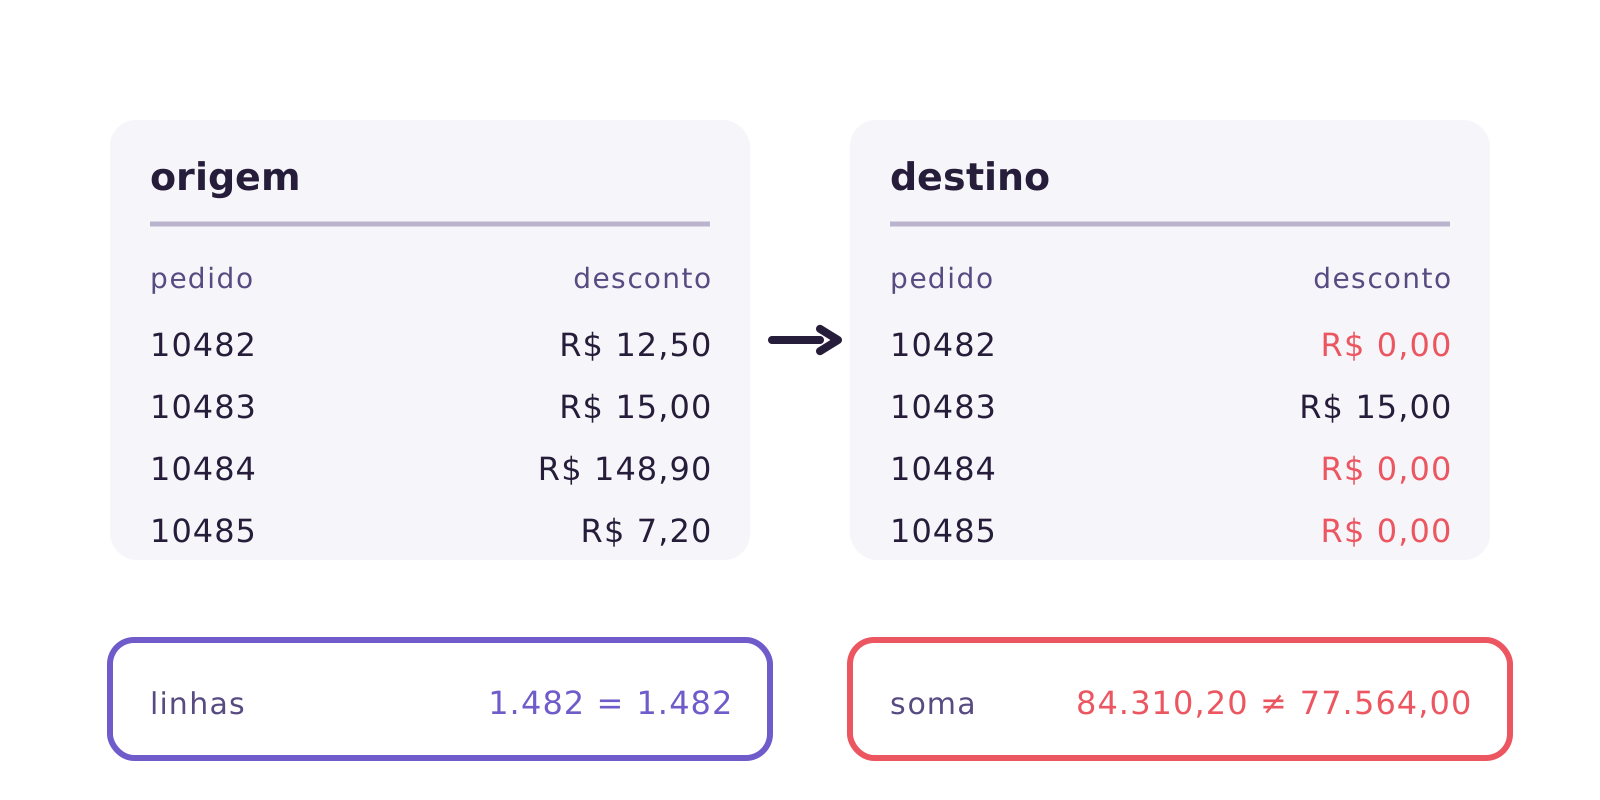
Uma rede de lojas migra o sistema de vendas num fim de semana. A carga roda, a contagem de pedidos bate e todo mundo comemora. Na terça, o relatório de faturamento aponta 8% a menos que o mês anterior: o campo de desconto vinha como texto com vírgula decimal e foi lido como zero em toda linha que tinha centavos. Ninguém conferiu soma de valor, só contagem de linha.
Como conferir que o dado chegou inteiro
Contagem de linha é o mínimo, e é insuficiente. Quatro verificações pegam a maior parte do que costuma passar:
Contagem por tabela, origem contra destino. Detecta linha perdida, não detecta valor errado.
Soma dos campos numéricos. Faturamento total, quantidade total, saldo — é o que teria pego o caso acima.
Amostragem dirigida. Não linhas aleatórias, e sim as difíceis: o pedido mais antigo, o de maior valor, o que tem caractere especial no nome, o que está cancelado.
Teste declarado que roda sozinho. Campo obrigatório que não pode vir vazio, chave que precisa ser única, valor que precisa estar numa lista. Rodando a cada carga, o erro aparece no dia em que surge, não na véspera da virada.
A regra é simples: valide durante, não depois.
Onde o Januss entra
O Januss serve ao segundo caminho, o da migração contínua. Carga inicial completa, captura de mudanças pelo log de transações em PostgreSQL, MySQL, SQL Server, Oracle e MongoDB, e os dois lados sincronizados até a virada. As exclusões aparecem, porque a leitura é do log e não de uma consulta agendada.
Antes da primeira carga, ele confere os pré-requisitos de CDC na origem — wal_level, binlog_format=ROW e equivalentes. Quando falta algum, a tela mostra o comando que resolve, inclusive o caminho diferente do Amazon RDS.
O tratamento de formato é resolvido na carga: treze regras de conversão que você encadeia por coluna, com oito formatos regionais, incluindo o R$ 1.234,56. E você decide, coluna a coluna, o que fazer com o valor que não converte: parar a execução ou gravar nulo.
Os testes de qualidade rodam a cada carga, não no fim. Campo obrigatório vazio, chave duplicada, relacionamento quebrado — cada teste pode só registrar um aviso ou parar a execução e bloquear o que vem depois.
Duas coisas o Januss não faz, e vale saber antes. Ele não converte modelo: decidir que o campo A do sistema antigo vira o campo B do novo continua sendo trabalho seu, em SQL. E a escrita é por lote, sem carga em bloco nativa — para volume muito alto em prazo curto, uma ferramenta especializada em movimentação em massa vai ser mais rápida.
Para o cenário mais comum — migrar mantendo a operação de pé e continuar sincronizando depois — o desenho serve. E tem uma vantagem que só aparece no fim: terminada a migração, a estrutura continua valendo como integração, em vez de ser descartada.
Quer testar com uma tabela sua antes de decidir? São 14 dias de teste, sem cartão de crédito: criar seu ambiente.
Crie seu workspace em minutos.
Aponte para a sua origem e veja o dado chegando ao banco no mesmo dia.