É a reunião de resultado do mês, e o número do faturamento está na tela. O diretor comercial olha e diz que aquele valor não fecha com o que ele acompanhou a semana inteira.
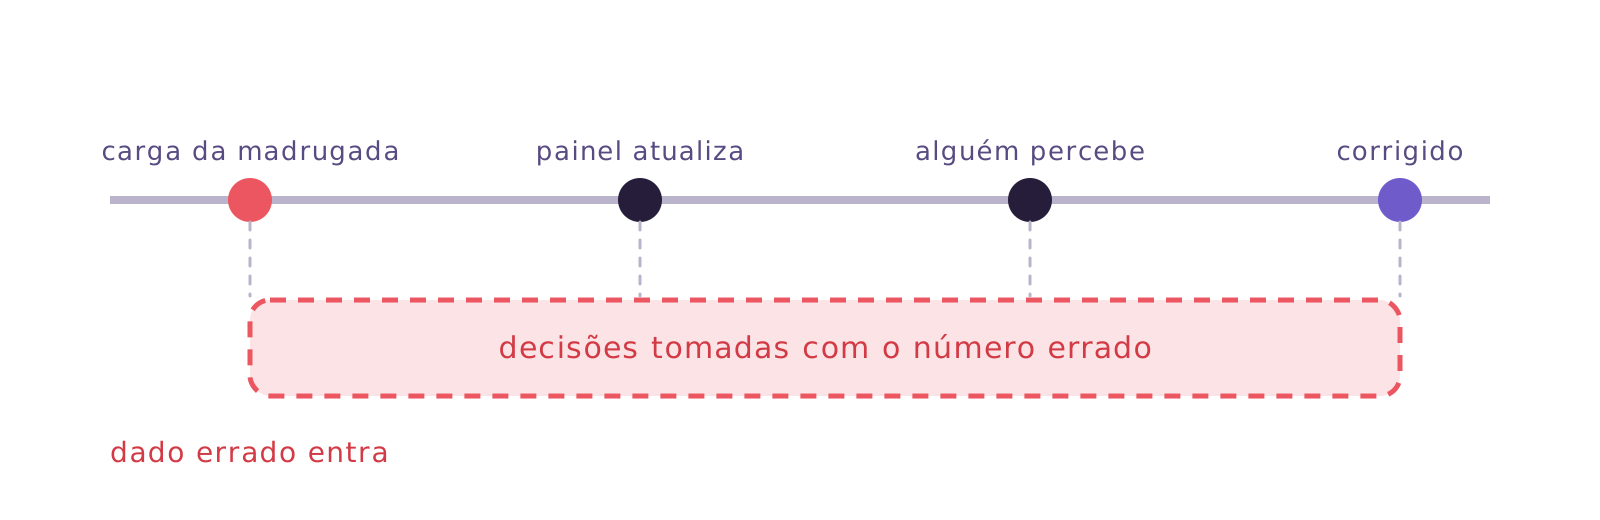
Ele tem razão. A carga da madrugada trouxe o pedido com o desconto zerado, o painel atualizou às seis da manhã e ninguém foi avisado.
O problema é que não havia o que avisar. O pipeline não quebrou: leu a origem, converteu, escreveu no destino e terminou com sucesso. Do ponto de vista da execução, foi um dia normal.
Neste artigo, explicamos por que o time de dados costuma ser o último a saber, o que separa uma falha barulhenta de uma silenciosa, e o que muda quando o teste deixa de rodar depois da carga e passa a rodar durante.
Quem descobre o erro primeiro
A cena da reunião não é exceção. É o padrão medido.
A Monte Carlo pesquisou isso com a Wakefield Research em março de 2023, ouvindo 200 profissionais de dados. 74% responderam que a área de negócio identifica os problemas antes do time, sempre ou quase sempre. No levantamento do ano anterior eram 47%.
O mesmo estudo mediu o tempo: a maioria leva quatro horas ou mais só para detectar um incidente, e a média de resolução ficou em quinze horas por incidente. O recorte é global, e não há corte para o Brasil — mas a mecânica não muda de país.
E aqui vale inverter a leitura. Esses números vêm de organizações grandes, com time de dados estruturado. Se a empresa com dezenas de engenheiros perde quatro horas para perceber e quinze para corrigir, o time de duas pessoas não perde menos. Perde a semana, porque quem corrige é exatamente quem deveria estar analisando.
Descobrir tarde não é falta de cuidado: é uma consequência de onde o teste está.
Falha barulhenta e falha silenciosa
Pipeline que quebra é o caso fácil. A execução para, o alerta chega, alguém abre o log e vê a mensagem. Ninguém toma decisão com base em número errado, porque não chegou número nenhum.
A falha silenciosa é a outra. A execução termina com sucesso e o dado chega — só que errado. Não há mensagem de erro para ler, não há alerta para disparar, e o painel atualiza normalmente. O sinal de que algo aconteceu é o próprio número, e quem olha o número todo dia é a área de negócio.
É por isso que a ordem se inverte. O time de dados monitora a execução; a área de negócio monitora o resultado. Quando o problema não aparece na execução, quem vê primeiro é quem olha o resultado.
O time não está distraído. Está olhando para o lugar em que nada aconteceu.
Por onde o erro entra sem quebrar nada
Cinco caminhos cobrem a maior parte dos casos, e nenhum deles derruba a execução:
- Conversão que devolve zero. O valor vem como texto com vírgula decimal, a conversão não reconhece o formato e grava zero. A linha existe, o total encolhe.
- Chave duplicada na origem. O mesmo pedido chega duas vezes, e a soma conta duas vezes. A carga não tem por que reclamar.
- Relacionamento quebrado. O pedido chega com um cliente que não existe na tabela de clientes. O relatório por cliente perde essas linhas em silêncio.
- Exclusão que não é capturada. A origem apagou o registro, a consulta agendada não tem como perceber, e o destino segue contando o que já não existe.
- Campo obrigatório vazio. A coluna que alimenta o filtro do painel chega nula, e as linhas simplesmente somem do recorte.
Exemplo prático
Uma rede de lojas troca o meio de pagamento no sistema de vendas. O campo de bandeira do cartão passa a vir com um código novo, que não está na lista de valores aceitos do painel. A carga roda normalmente e grava tudo. O relatório de vendas por bandeira passa a mostrar uma fatia grande em branco, e ninguém percebe até a reunião de fechamento.
Nenhum desses casos é exótico, e todos eles terminam a execução com sucesso.
Testar depois da carga e testar durante
A diferença entre descobrir na reunião e descobrir antes dela quase sempre é o momento em que o teste roda.
Teste depois da carga. A tabela é construída, e uma consulta confere o resultado. Funciona, e é assim que a maior parte das ferramentas trabalha. O ponto é que, quando o teste acusa, o dado já está no destino — e o painel já leu de lá.
Teste durante a carga. A verificação acontece no caminho, antes da gravação, e pode interromper a execução. Se ela interrompe, o destino permanece como estava: o painel continua mostrando o número da véspera, que está correto, em vez do número novo, que está errado.
A diferença aparece na janela. Testar depois encurta o tempo de detecção, e é muito melhor que não testar. Testar durante fecha a janela em que alguém decide com o número errado na tela.
O que o teste não pega
Aqui vale ser direto, porque teste declarado não é um seguro contra tudo.
Ele não pega erro de regra de negócio. Se a receita foi calculada com a alíquota errada, o valor é um número plausível, não nulo nem duplicado. Nenhuma verificação de estrutura vai reclamar de um número que parece certo.
Ele não pega o que ninguém declarou. Teste é uma afirmação escrita por alguém: esta coluna não pode ser nula, este valor precisa estar nesta lista. O que não foi escrito não é conferido, e a lista cresce com o tempo, junto com os erros que apareceram.
E parar a carga tem um preço. Um pipeline interrompido significa painel desatualizado, e desatualizado também incomoda. Existe a decisão, por teste, entre apenas registrar um aviso e parar de fato — e ela não é óbvia.
A regra prática que funciona: pare quando o número errado for pior que o número velho. Faturamento, saldo, estoque, base de comissão — aí o número velho é o menor dos males. Para uma coluna de apoio que ninguém soma, o aviso resolve.
Não é toda tabela que merece um freio.
Onde o Januss entra
No Januss, o teste é parte da carga, não uma etapa separada depois dela.
São cinco tipos: não nulo, único, valores aceitos, relacionamento entre tabelas e SQL próprio para o caso que os outros quatro não cobrem. Cada um tem severidade. Aviso apenas registra; Erro para a execução e bloqueia as etapas que dependem dela. O dado reprovado não chega ao destino, e o que vinha depois não roda com base nele.
Antes disso, ainda na conversão, há a política de erro por coluna: o valor que não converte pode parar a execução ou virar nulo, e a escolha é sua, coluna a coluna. É o caso do desconto que vira zero, resolvido antes de virar um número na tela.
Quando a execução para, o e-mail sai com o erro e o link direto para a execução. Quando volta a rodar, sai o e-mail de recuperação. E depois de três falhas seguidas o pipeline se desliga sozinho, em vez de insistir em silêncio.
O que o Januss não faz, e vale dizer aqui. Ele não é uma plataforma de observabilidade: não detecta anomalia sozinho, não desenha mapa de dependências entre sistemas e não descobre o teste que você não escreveu. O que ele faz é executar as verificações que você declarou, na hora em que elas ainda podem evitar a gravação.
Quer ver com uma tabela sua? São 14 dias de teste, sem cartão de crédito: criar seu ambiente.
Fontes
Os números de mercado deste artigo vêm de uma fonte só, aberta na origem:
Crie seu workspace em minutos.
Aponte para a sua origem e veja o dado chegando ao banco no mesmo dia.