É dia de fechamento e o comercial abre o relatório de carteira ativa.
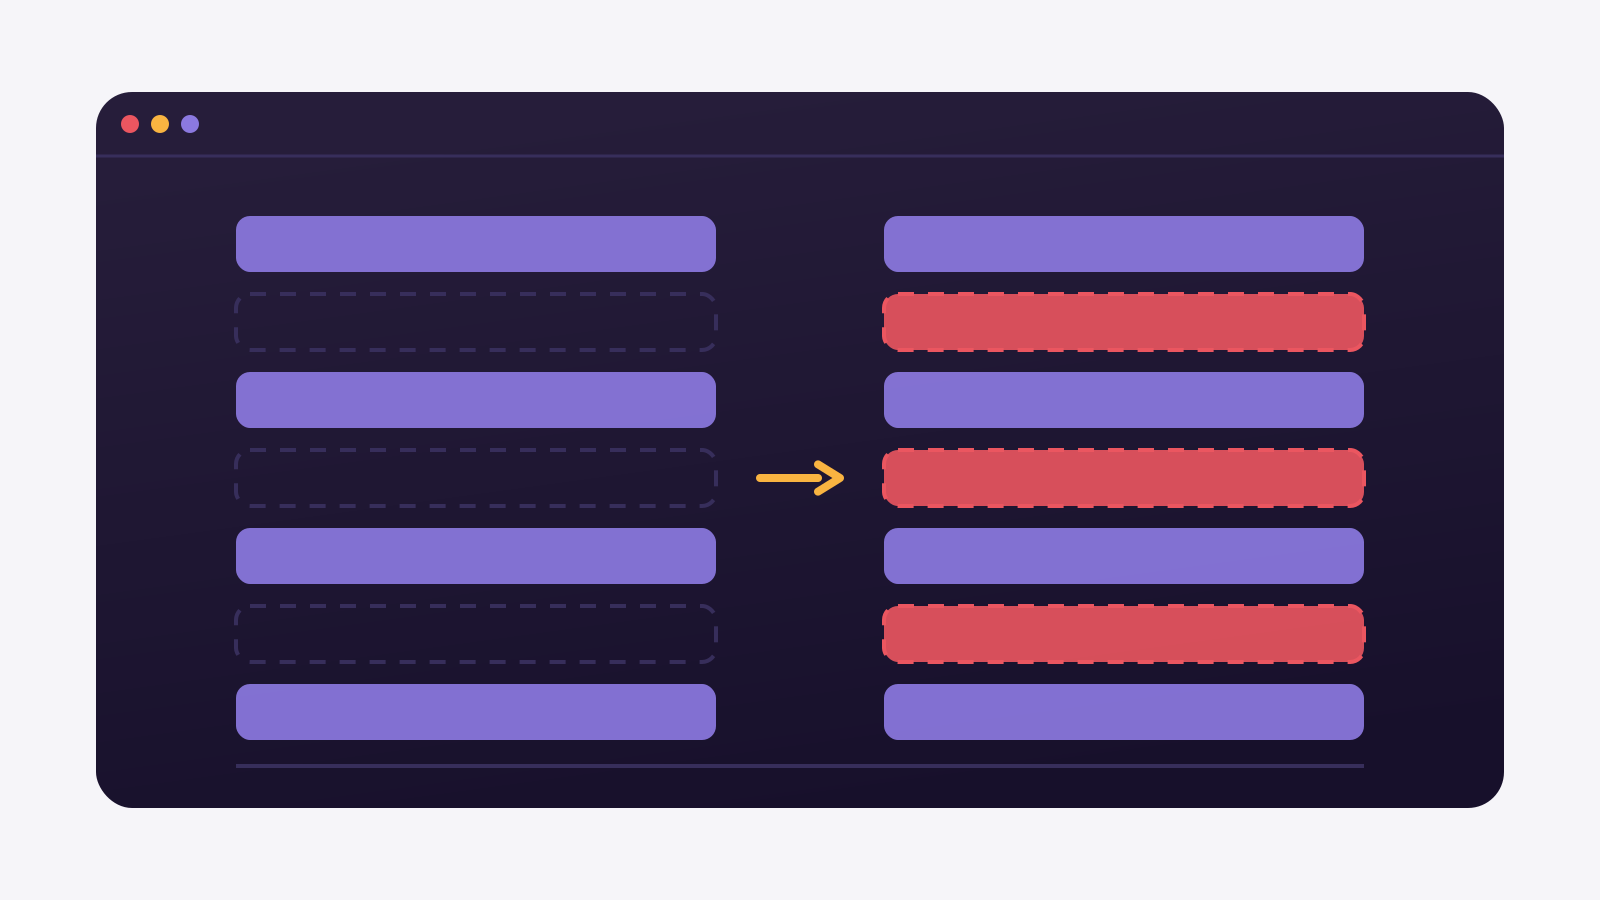
A contagem de clientes do painel não bate com a do CRM. Ninguém apagou nada errado, e as duas telas leem a mesma base. O problema é que o pipeline nunca recebeu a ordem de apagar.
Neste artigo, explicamos por que um registro excluído na origem sobrevive no destino, como medir quantos você já tem e o que muda em cada caminho de correção.
Um DELETE não atualiza coluna nenhuma na origem
A sincronização por cursor faz sempre a mesma pergunta à origem: quais linhas mudaram desde a última leitura. Ela compara uma coluna de data, quase sempre updated_at, com a marca guardada na execução anterior.
O DELETE escapa dessa pergunta. Quando alguém remove uma linha, não sobra linha para carregar data nenhuma. O registro sai da origem sem tocar na coluna que o cursor lê, e por isso nunca entra no lote que o pipeline traz.
O mesmo vale para leitura de API. Um endpoint que devolve pedidos alterados depois de uma data devolve pedidos que existem. Pedido cancelado e removido não aparece em lista nenhuma, porque a lista é de coisas presentes.
Ausência não é um evento.
O que o upsert faz e não faz
Chegado o lote, o destino precisa decidir o que fazer com cada linha. O upsert resolve dois casos: se a chave já existe, atualiza os campos; se não existe, insere a linha nova.
O terceiro caso não tem dono. Linha que estava no destino e não veio no lote continua exatamente como estava. O upsert não tem como distinguir entre uma linha que sumiu da origem e uma linha que apenas não mudou desde ontem.
Exemplo prático
Uma distribuidora de material elétrico limpa a base do ERP e remove 400 cadastros repetidos. No dia seguinte o ERP mostra a base correta, e o painel de vendas segue com os 400 — que agora aparecem como quem não compra há meses. O time de marketing tem uma lista de reativação inteira feita de gente que não existe.
Ninguém apagou. Ninguém foi avisado.
Como contar os registros fantasma no seu destino
Antes de escolher a correção, vale medir o tamanho do problema. A conta mais barata é comparar a contagem das duas pontas, tabela a tabela, no mesmo instante.
Contagem das duas pontas, rodada na origem e no destino
-- rode a mesma consulta nos dois bancos e compare
SELECT COUNT(*) AS linhas FROM public.clientes;

-- se a diferença existir, traga as chaves que só existem no destino
SELECT d.cliente_id
  FROM destino.clientes d
  LEFT JOIN origem_espelho.clientes o ON o.cliente_id = d.cliente_id
 WHERE o.cliente_id IS NULL;
Diferença pequena e estável costuma ser atraso de sincronização: o lote da madrugada ainda não rodou. Diferença que só cresce, semana após semana, é outra coisa. É o destino guardando linhas que a origem já não tem.
A contagem sozinha não diz quais linhas sobraram. Para isso é preciso trazer as chaves das duas pontas e subtrair uma da outra. Em tabela grande esse SELECT é caro, então rode fora da janela de carga.
Meça antes de decidir.
Recarga completa, marcação de exclusão, leitura do log
Existem três formas de fazer o apagamento chegar ao destino. As três funcionam, e a diferença entre elas é o preço que cada uma cobra.
- Recarga completa. Você joga a tabela fora e traz tudo de novo. É o método mais simples de explicar e o único que não depende de nada na origem. Também é o que mais lê, mais escreve e mais demora, todo dia, para corrigir um punhado de linhas.
- Marcação de exclusão. Em vez de apagar, o destino ganha uma coluna que diz que a linha saiu da origem. O histórico continua consultável e o relatório passa a filtrar por essa coluna. Só funciona se alguém lembrar de colocar o filtro em toda consulta.
- Leitura do log de transação. O banco de origem já escreve cada INSERT, UPDATE e DELETE no log dele para poder se recuperar de uma queda. Ler esse log é o que se chama de CDC (change data capture): o apagamento chega como evento, com a chave da linha removida.
A ordem acima é de esforço crescente na origem e de custo decrescente na operação. Quem não pode mexer na origem fica com as duas primeiras.
O que cada caminho custa na prática
Nenhuma das três saídas é de graça, e a conta muda conforme o tamanho da tabela e o que a origem deixa você ligar.
| O que exige da origem | O que custa | |
|---|---|---|
| Recarga completa | Nada | Lê e escreve a tabela inteira em toda execução |
| Marcação de exclusão | Nada | Todo relatório precisa filtrar a coluna de exclusão |
| Leitura do log | Log de transação ligado, um slot de replicação e chave primária ou replica identity na tabela | Configuração no banco e acompanhamento do slot |
A coluna do meio é a que costuma decidir: em banco gerenciado por terceiro, ligar o log de transação depende de quem administra o servidor.
A leitura por log tem pré-requisitos que não são seus. Ela depende de o banco de origem permitir ligar o log de transação e de sobrar espaço para o slot de replicação segurar as alterações. Em banco de terceiro, isso é uma conversa, não uma configuração.
E depende da tabela, não só do servidor. O apagamento só chega identificável se a tabela tiver chave primária ou replica identity configurada. Sem uma das duas, o evento de DELETE não carrega a chave da linha que saiu, e o destino não sabe o que remover.
A marcação de exclusão tem um custo mais silencioso: ela transfere a responsabilidade para quem escreve a consulta. Basta um relatório novo esquecer o filtro para o número errado voltar, agora com cara de erro do analista.
Escolha pelo que você controla.
Quando a linha morta não atrapalha o relatório
Nem toda divergência entre origem e destino precisa de projeto. Antes de mexer no banco de produção, vale perguntar se aquela linha chega a aparecer em alguma conta.
Tabela de apoio quase nunca sofre. Lista de estados, de formas de pagamento, de centros de custo: são bases pequenas, que mudam devagar e que uma recarga completa diária resolve sem ninguém sentir. O trabalho de ligar leitura por log ali não se paga.
Fato histórico também costuma preferir a linha parada. Uma nota fiscal emitida e depois cancelada não deveria sumir do faturamento do mês passado, porque o mês passado aconteceu. Nesse caso a linha morta não é sujeira, é registro, e o que falta é a coluna que diz que ela foi cancelada.
O problema aparece quando a tabela responde a uma pergunta do presente. Carteira ativa, estoque disponível, usuários habilitados: aí a linha que sobrou vira número errado, e não há filtro esperto que salve quem não sabe que ela está lá.
Corrija o presente. Preserve o passado.
Onde o Januss entra
No Januss o modo de sincronização é escolhido por tabela, não por conexão. A mesma origem pode ter uma tabela em carga completa, outra em espelhamento e outra em histórico com vigência, e a marcação de exclusão é configurável stream a stream.
A leitura por log de transação cobre cinco bancos de origem. PostgreSQL, MySQL, SQL Server, Oracle e MongoDB, em todos os planos, inclusive o de entrada. Antes de salvar, o Januss confere os pré-requisitos do banco e diz na tela qual comando resolve o que ainda falta.
Na transformação, o incremental tem uma garantia declarada: a tabela de destino fica idêntica, linha a linha, ao que uma recarga completa produziria. Ele reprocessa só o escopo que mudou e apaga o que sumiu, que é exatamente onde o upsert sozinho deixa lixo. Quando a consulta agrega sobre JOIN e o escopo não dá para isolar, o motor reconcilia tudo e diz o motivo em vez de entregar um número aproximado.
Quer conferir a contagem com o seu dado? O trial de 14 dias não pede cartão, e dá para colocar uma tabela no ar e comparar as duas pontas na mesma tarde. Criar seu ambiente no Januss.
Fontes
O comportamento do apagamento na leitura por log, e a condição para ele carregar a chave da linha removida, estão documentados no plugin de saída mais usado com PostgreSQL:
Crie seu workspace em minutos.
Aponte para a sua origem e veja o dado chegando ao banco no mesmo dia.